El 18 de noviembre de 2025, a las 11:05 UTC, Cloudflare desplegó un cambio de permisos en un clúster de ClickHouse, la base de datos columnar que usa para analítica. Nada exótico: hacer explícito que ciertos usuarios podían ver las tablas subyacentes de una base de datos llamada r0. Una consulta que llevaba tiempo funcionando, algo tan inocente como pedir la lista de columnas de la tabla http_requests_features, empezó a devolver cada columna dos veces, una por la base de datos de siempre y otra por r0.
Esa consulta alimentaba el fichero de features que usa el sistema de gestión de bots de Cloudflare. En aprendizaje automático, una feature es cada una de las características que mira un modelo para tomar una decisión; aquí, si una petición parece de una persona o de un bot (las cabeceras, el ritmo de peticiones, la huella del navegador…). El fichero con la lista de esas características se regenera cada pocos minutos y se distribuye a toda la red. En condiciones normales llevaba unas 60 entradas. El proxy que lo consume, escrito en Rust, tenía reservada memoria para un máximo de 200. Con las columnas duplicadas el fichero se pasó del límite, y el proxy hizo lo que hace un programa en Rust cuando alguien ha escrito .unwrap() sobre un error que «no puede pasar». En Rust, las operaciones que pueden fallar devuelven un resultado que es o bien el valor esperado o bien un error, y el lenguaje obliga a decidir qué hacer en cada caso. .unwrap() es la forma corta de decir «estoy seguro de que aquí hay un valor; si no lo hay, detén el programa». Es como firmar un cheque sin mirar el saldo: funciona mientras haya dinero, y cuando no lo hay, el banco no negocia. Aquí no lo había, y el proceso se detuvo en seco con un panic, el error fatal de Rust:
thread fl2_worker_thread panicked: called Result::unwrap() on an Err value
Lo que vino después Cloudflare lo describió como su peor caída desde 2019. Y lo más interesante del postmortem no es la causa, sino lo difícil que fue verla. (En el mundo SRE se llama postmortem al informe que se escribe después de un incidente. El término viene de la medicina, donde designa la autopsia, y la intención es la misma: entender qué pasó, no buscar a quién culpar.) El fichero se generaba cada cinco minutos en un clúster que se estaba actualizando nodo a nodo: si la consulta caía en un nodo ya actualizado, el fichero salía corrupto; si caía en uno antiguo, salía bien. La red entera se caía, se recuperaba y volvía a caerse. El equipo sospechó primero de un ataque DDoS (una denegación de servicio distribuida: miles de máquinas inundando de tráfico un objetivo), y la sospecha cobró fuerza cuando la página de estado de Cloudflare, alojada fuera de su infraestructura, se cayó a la vez por pura coincidencia.
Hay un detalle más que a quien vive de la observabilidad le debería escocer: durante el incidente, los sistemas de depuración y observabilidad de Cloudflare consumían grandes cantidades de CPU enriqueciendo automáticamente cada error no capturado con información extra. La monitorización empeoraba la latencia que intentaba explicar.
Este artículo va de por qué este patrón se repite, en empresas con los mejores equipos de SRE del mundo (Site Reliability Engineering, la disciplina que popularizó Google para tratar la fiabilidad como un problema de ingeniería de software), y qué tiene que ver con cómo observamos (o no) los cambios de configuración.
Tres caídas con la misma forma
Si el caso de Cloudflare fuera único, sería una anécdota. No lo es.
El 12 de junio de 2025, Google Cloud sufrió una caída global de sus APIs. El 29 de mayo se había desplegado una funcionalidad nueva en Service Control, el sistema que decide si una llamada a una API de Google está autorizada y dentro de cuota. El código pasó el despliegue región a región habitual sin un solo error. El problema es que la ruta de código nueva solo se ejecutaba cuando llegaba cierto tipo de política, y durante el despliegue no llegó ninguna. El 12 de junio alguien insertó en Spanner, la base de datos distribuida a escala global de Google, una política con campos en blanco, esa política se replicó globalmente en segundos, el código intentó usar un puntero nulo y los binarios entraron en bucle de reinicios en todas las regiones a la vez. Un puntero nulo es una referencia que no apunta a nada, como una nota con la dirección de una casa que no existe: el programa va a buscarla, no encuentra nada y, si nadie ha previsto ese caso, se cae. El bucle de reinicios es la consecuencia: el proceso arranca, lee la política, falla y vuelta a empezar. El informe de Google lo dice sin adornos: el código había pasado por el despliegue por regiones, pero «the code path that failed was never exercised during this rollout».
El 20 de febrero de 2026, otra vez Cloudflare. Una tarea de limpieza automática debía retirar prefijos BYOIP marcados para borrar. BYOIP significa Bring Your Own IP: rangos de direcciones IP que pertenecen al cliente y que Cloudflare anuncia en internet en su nombre. Un prefijo es uno de esos rangos (por ejemplo, un /24), y retirarlo equivale a borrar una carretera del mapa: el resto de internet deja de saber cómo llegar a esas direcciones. La tarea llamó a la API así:
resp, err := d.doRequest(ctx, http.MethodGet, `/v1/prefixes?pending_delete`, nil)
Y el servidor comprobaba el parámetro así:
if v := req.URL.Query().Get("pending_delete"); v != "" {
pending_delete sin valor devuelve una cadena vacía, la condición no se cumple, el filtro no se aplica y la API responde con todos los prefijos. La tarea empezó a retirarlos metódicamente: 1.100 de 4.306 antes de que alguien se diera cuenta. Seis horas y siete minutos hasta la restauración completa.
Tres incidentes, tres empresas y equipos distintos, y la misma forma: un dato (una política, un fichero de features, un parámetro) con una propiedad que nadie esperaba (campos vacíos, filas duplicadas, un valor ausente) llegó a todas partes a la vez y activó un comportamiento que el código admitía pero nadie había probado.
La receta y el camión de la sal
La mejor forma que he encontrado de explicar por qué esto pasa en empresas que despliegan código con un cuidado exquisito es pensar en una cadena de restaurantes.
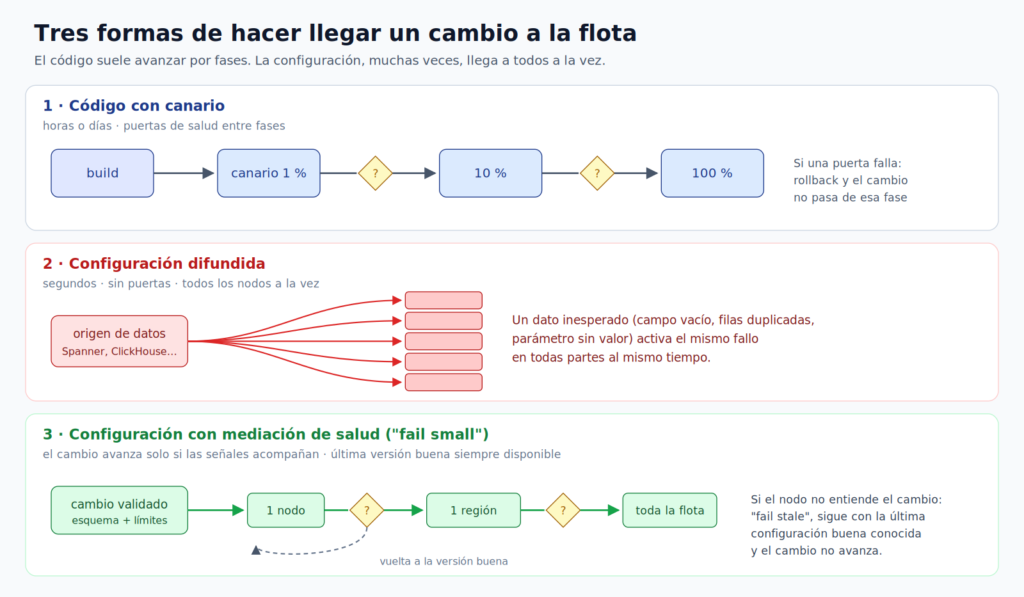
Cuando la cadena cambia una receta, la prueba primero en un local, luego en diez, luego en todos. Si los clientes del primer local devuelven los platos, la receta nueva no sale de ahí. En software a esto se le llama despliegue canario (canary release), por los canarios que los mineros bajaban a la mina de carbón: si había gas, el pájaro caía antes que ellos y daba tiempo a salir. El primer grupo pequeño de servidores hace de canario, y el cambio solo avanza a la siguiente fase si ese grupo sigue sano. Si algo va mal, se hace rollback: se vuelve a la versión anterior antes de que el cambio llegue a más sitios.
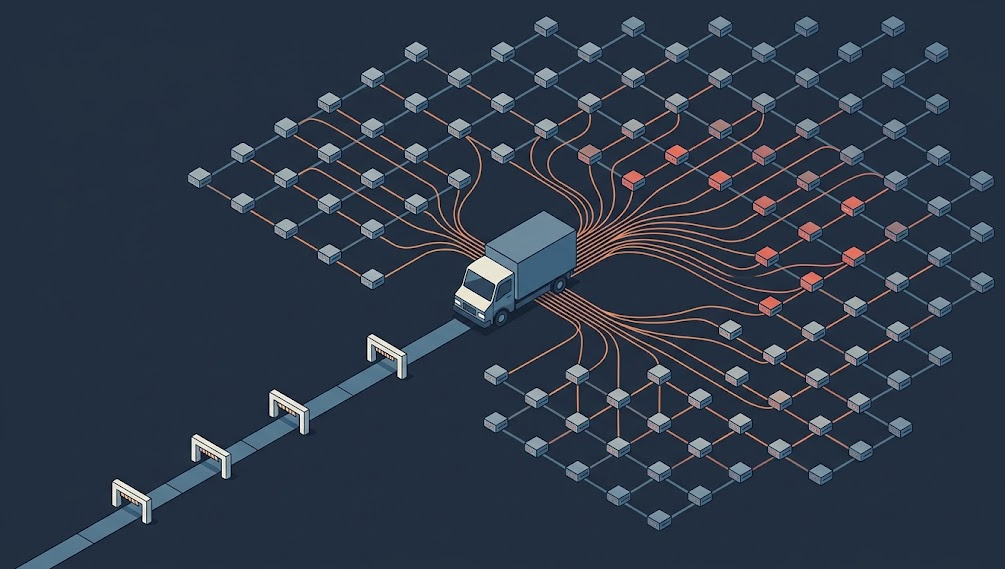
Pero la sal no llega así. La sal la reparte un camión que visita todos los locales la misma mañana. Si un lote viene contaminado, la receta nueva da igual (la vieja también lleva sal), y no hay ningún local piloto que lo detecte antes que los demás. Todas las cocinas fallan a la vez.
La configuración es la sal. Y en infraestructura moderna, buena parte de lo que cambia a diario no es el binario sino los datos que el binario consume: reglas del WAF (el cortafuegos de aplicaciones web, que filtra peticiones maliciosas antes de que lleguen a la aplicación), políticas de cuota, listas de features, feature flags (interruptores dentro del código que activan o desactivan una funcionalidad sin volver a desplegar), tablas de enrutado, plantillas de alerta. El código pasa por el comité de recetas; la configuración llega en el camión.
 DESPLIEGUE DE CÓDIGO                     PROPAGACIÓN DE CONFIGURACIÓN
 ════════════════════                     ════════════════════════════

  build ──► canario 1% ──► 10% ──► 100%     origen (Spanner, ClickHouse,
               │            │                        Quicksilver, etcd...)
            ¿sano?       ¿sano?                         │
               │            │                 ┌─────┬───┴──┬─────┬─────┐
            si no:       si no:               ▼     ▼      ▼     ▼     ▼
            rollback     rollback           [nodo][nodo][nodo][nodo][nodo]

  Tiempo típico: horas o días               Tiempo típico: segundos
  Barreras: tests, canario, salud           Barreras: a menudo, ninguna
En el diagrama, Quicksilver es el sistema interno con el que Cloudflare reparte la configuración a sus centros de datos de todo el mundo en segundos, y etcd es el almacén de configuración sobre el que funciona Kubernetes: dos ejemplos de camión de la sal.
La pregunta obvia es por qué la sal no pasa también por un local de prueba antes de llegar a todos. Y la respuesta es que la rapidez no es un descuido: es el motivo de que exista ese canal. El fichero de features de gestión de bots se regenera cada pocos minutos porque los bots cambian de comportamiento cada pocos minutos, y una defensa que tarda un día en desplegarse no defiende. Las políticas de cuota de Google se replican en segundos porque un cliente que paga más cuota la quiere ya, no mañana.
El 5 de diciembre de 2025 Cloudflare lo volvió a comprobar de la peor manera. Para proteger a sus clientes frente a la vulnerabilidad de React Server Components (CVE-2025-55182) aumentó el tamaño del buffer del WAF de 128 KB a 1 MB, y al desactivar con un killswitch (un interruptor de emergencia que apaga una funcionalidad al instante, el equivalente en software a la seta roja de parada de una máquina industrial) una herramienta interna de pruebas que no soportaba ese tamaño, un trozo de código en Lua intentó acceder a un campo nulo. Veinticinco minutos de errores 500 para aproximadamente el 28 % del tráfico HTTP que sirve Cloudflare. El cambio era urgente y legítimo, y viajó por el sistema de configuración global precisamente porque era urgente. En su postmortem Cloudflare reconoció que las mejoras prometidas tras el incidente de noviembre «we have not finished deploying them yet».
Lo que Cloudflare llamó «fallar en pequeño»
Tras el incidente de diciembre, Cloudflare declaró internamente un «Code Orange». En su jerga significa que un proyecto pasa por delante de todo lo demás y que los equipos pueden aparcar otros trabajos para dedicarse a él; según contaron, era solo la segunda vez que lo hacían en la historia de la empresa. Le pusieron un lema que resume bien el cambio de mentalidad: Fail Small, fallar en pequeño. La idea es la de los compartimentos estancos de un barco: no se trata de que nunca entre agua, sino de que, si entra, inunde un compartimento y no el barco entero. El 1 de mayo de 2026 publicó el balance. Merece la pena leerlo con calma porque es un catálogo de soluciones a problemas que casi todos tenemos, a menor escala.
La pieza central se llama Snapstone: un sistema que empaqueta cada cambio de configuración y lo libera de forma gradual «with health mediation principles», es decir, el cambio avanza mientras las señales de salud acompañan y se revierte solo cuando no. Las señales de salud son las métricas que dicen si un servicio funciona bien (tasa de errores, latencia, reinicios), y lo de «mediación» significa que son ellas, y no un calendario fijo, las que deciden si el despliegue sigue adelante. En la analogía de antes, el camión de la sal pasa a repartir primero a un local, espera a ver qué pasa con los platos, y solo entonces sigue la ruta.
La segunda idea es fail stale. En inglés, stale es lo que ha perdido frescura, como el pan del día anterior: no es lo ideal, pero se puede comer. Aplicado a la configuración, significa que cuando un componente recibe una configuración que no puede procesar, en lugar de morir sigue funcionando con la última configuración buena conocida, aunque ya no sea la más reciente. Y cuando eso no es posible, cada caso se ha revisado para decidir conscientemente si el componente debe fallar abierto (dejar pasar) o cerrado (bloquear). Los términos vienen de la seguridad física, y el ejemplo clásico son las cerraduras electrónicas: si se va la luz, la puerta de una salida de emergencia debe quedarse abierta para que la gente pueda salir, y la de la cámara acorazada de un banco debe quedarse cerrada. Ninguna de las dos está mal; depende de qué protege cada puerta. Esta decisión parece menor hasta que piensas en un WAF: fallar abierto significa servir tráfico sin protección; fallar cerrado significa tumbar a tus clientes. Ninguna es gratis y ambas deben ser una decisión tomada en frío, no el efecto secundario de un unwrap().
La tercera es cultural y la cuento porque me hizo gracia su franqueza: un código de ingeniería (un reglamento interno de buenas prácticas de programación) con reglas que se comprueban automáticamente en la revisión de código, entre ellas «Do not use .unwrap() outside of tests and build.rs«, es decir, nada de .unwrap() fuera de las pruebas y de los scripts de compilación, y otra que obliga a que los servicios validen que sus dependencias están en un estado esperado antes de procesar nada. El postmortem de noviembre ya apuntaba en esa dirección con una frase que conviene colgar en la pared: tratar los ficheros de configuración generados internamente con la misma desconfianza que la entrada de un usuario.
Google, en su informe de junio, llegó a conclusiones muy parecidas por otro camino: toda funcionalidad nueva en binarios críticos detrás de un feature flag desactivado por defecto, auditar cualquier sistema que consuma datos replicados globalmente y, esta es la que más me interesa, asegurar reintentos con backoff exponencial aleatorizado. El backoff es la espera entre un intento fallido y el siguiente; exponencial quiere decir que esa espera se duplica cada vez (1 segundo, 2, 4, 8…), y aleatorizado, que a cada espera se le suma un pequeño margen al azar para que no todos los clientes vuelvan a intentarlo en el mismo instante. Es lo que hacemos sin pensar cuando un teléfono comunica: no marcamos cien veces seguidas, esperamos un poco más cada vez.
Google lo aprendió por las malas. Cuando pulsaron el «botón rojo» (así llaman en su informe al interruptor de emergencia que desactivó la ruta de código problemática), la región us-central1 tardó mucho más en recuperarse que las demás: todas las tareas de Service Control reiniciaron a la vez y aplastaron la misma tabla de Spanner de la que dependían. En inglés se llama thundering herd, la manada en estampida, y la imagen es exacta: cada animal corre por su cuenta, pero todos en la misma dirección y al mismo tiempo. Es el mismo fenómeno que cuando vuelve la luz tras un apagón y todas las neveras del barrio arrancan el compresor en el mismo segundo.

Figura: el código suele avanzar por fases con puertas de salud; la configuración se difunde a todos los nodos a la vez. «Fail small» consiste en llevar las puertas de salud también al canal de configuración y tener siempre a mano la última versión buena.
Dónde entra la observabilidad (y dónde se queda corta)
Todo esto parece un tema de ingeniería de despliegues, y lo es. Pero hay una razón por la que lo traigo a un blog de observabilidad: la «mediación de salud» de Snapstone solo funciona si hay señales de salud que merezcan ese nombre, y la mayoría de organizaciones no sabría decir, mirando sus paneles, qué versión de configuración está aplicada en cada nodo.
Piénsalo al revés. Cuando algo se degrada, la primera pregunta de cualquier triaje es «¿qué ha cambiado?». Triaje es otra palabra prestada de la medicina: en urgencias, clasificar a los pacientes por gravedad antes de tratarlos; en un incidente, decidir qué mirar primero. Para el código solemos tener respuesta, porque los pipelines de CI/CD (integración y despliegue continuos) registran cada despliegue. Para la configuración, muy a menudo no. El cambio de permisos en ClickHouse de Cloudflare no era un despliegue de nada; era una modificación en una base de datos cuyo efecto aparecía, indirectamente, en un fichero generado por otro proceso. Ningún panel iba a mostrar «a las 11:05 cambió algo» encima de la gráfica de errores.
De ahí salen tres prácticas que no requieren ser Cloudflare.
La primera: cada cambio de configuración es un evento. Si tu herramienta lo permite, envíalo al mismo sitio donde miras las métricas. En Dynatrace, la API de eventos v2 tiene un tipo específico para esto, CUSTOM_CONFIGURATION, pensado para marcar cambios de configuración sobre las entidades afectadas. En un Managed la llamada es la misma que en SaaS, cambiando la URL base:
# Registrar un cambio de configuración sobre los servicios afectados
# (token clásico con el scope events.ingest)
curl -X POST "https://{tu-cluster}/e/{environment-id}/api/v2/events/ingest" \
  -H "Authorization: Api-Token ${DT_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
        "eventType": "CUSTOM_CONFIGURATION",
        "title": "Reglas WAF v2026.10.05-1",
        "entitySelector": "type(SERVICE),tag(capa:frontal)",
        "properties": {
          "config.version": "2026.10.05-1",
          "config.origen": "repo infra-waf, commit 3f9c2ab",
          "config.anterior": "2026.10.02-3"
        }
      }'
El valor no está en la llamada, que es trivial, sino en que el evento aparece sobre la entidad en el momento exacto, y el motor de correlación (lo que ahora Dynatrace llama Dynatrace Intelligence y antes Davis) puede tenerlo en cuenta al analizar un problema posterior. En Prometheus y Grafana la idea equivalente son las anotaciones: marcas verticales sobre las gráficas que indican que en ese momento pasó algo, como las chinchetas que se clavan en un mapa.
La segunda: la versión de configuración como dimensión. Si cada nodo expone qué versión de configuración tiene cargada, puedes comparar la tasa de errores entre nodos con la versión nueva y nodos con la antigua. Esto convierte cualquier despliegue gradual en un experimento con grupo de control, como en un ensayo clínico: unos nodos reciben el cambio y otros no, y la diferencia entre ambos grupos es el efecto del cambio. Un ejemplo en PromQL, suponiendo que tus servicios exponen una etiqueta config_version:
# Ratio de errores 5xx por versión de configuración, últimos 5 minutos
sum by (config_version) (rate(http_requests_total{code=~"5.."}[5m]))
/
sum by (config_version) (rate(http_requests_total[5m]))
Si la versión nueva tiene el triple de errores que la vieja en los mismos minutos, no necesitas IA para saber qué revertir. Ojo a la cardinalidad, que es el número de combinaciones distintas de valores que pueden tomar las etiquetas de una métrica: cada combinación genera una serie temporal nueva que hay que almacenar y consultar. Una etiqueta con la versión de configuración, que cambia unas pocas veces al día, está bien; una con un identificador distinto para cada regla individual multiplica las series, y con ellas la memoria y la factura.
La tercera, la más incómoda: tu observabilidad forma parte del radio de impacto. El radio de impacto (blast radius) es un término que viene de los explosivos, la zona que alcanza una explosión, y en sistemas se usa para hablar de hasta dónde llegan los daños de un fallo. Cloudflare enriquecía cada error con información de depuración y, cuando los errores pasaron de cientos a millones por segundo, ese enriquecimiento se comió la CPU de las máquinas que ya estaban en apuros. Una de sus acciones correctivas fue impedir que los volcados de memoria (copias del contenido de la memoria de un proceso en el momento de fallar, muy útiles para depurar y muy pesadas) y los informes de error puedan saturar los recursos del sistema. Aplica a cualquiera: un agente que escribe logs sin límite en el mismo disco que la aplicación, un exportador que reintenta sin backoff contra un backend caído, un tracer (el componente que genera las trazas distribuidas) que captura el cuerpo de cada petición fallida. Todo lo que funciona bien con un error por minuto hay que pensarlo con un millón.
Los límites de «fallar en pequeño»
Sería deshonesto terminar como si Snapstone y compañía fueran la receta universal.
Hay configuración que tiene que llegar a todas partes rápido. El cambio del 5 de diciembre era una defensa contra una vulnerabilidad que se estaba explotando; si lo hubieran desplegado en fases durante seis horas, habrían dejado expuestos a sus clientes durante esas seis horas. La mediación de salud compra seguridad a cambio de tiempo, y hay cambios en los que ese tiempo también es un riesgo. Lo razonable es tener dos carriles: uno gradual para el día a día y uno rápido, con más revisión humana y un rollback probado, para emergencias.
El despliegue canario de configuración también tiene un punto ciego clásico: el canario solo avisa de lo que le afecta mientras lo estás mirando. Si el fallo no se manifiesta en ese grupo durante la ventana de observación, el cambio sigue adelante tan tranquilo. El caso de Google es el ejemplo perfecto de lo contrario, un defecto que no se manifestó durante semanas porque necesitaba un dato concreto para despertar. Contra eso protege más la validación del dato (esquemas, límites explícitos, rechazar campos vacíos) que cualquier despliegue gradual.
Y a escala pequeña, que es donde vivimos casi todos, la tentación es pensar que esto no va con nosotros. Pero basta con un Ansible que empuja un sshd_config a 100 servidores en paralelo, o una plantilla de alertas que se aplica de golpe a todas las zonas de gestión de un tenant (las management zones con las que Dynatrace divide un entorno por equipos o aplicaciones), para reproducir el mismo patrón en miniatura. La diferencia con Cloudflare es que nosotros no publicamos postmortems.
Lo que me llevo
Lo que más me ha hecho pensar de estos incidentes es que en ninguno falló la parte que solemos proteger. El código de Google pasó su despliegue por regiones. El proxy de Cloudflare llevaba meses funcionando con ese límite de 200. La tarea de limpieza de BYOIP hacía exactamente lo que el código le pedía. Lo que falló fue el camino por el que viajan los datos que ese código consume, un camino diseñado para ser rápido y en el que la observabilidad llega, en el mejor de los casos, después.
Si hay que quedarse con una idea práctica para esta semana, sería esta: haz inventario de los canales por los que cambia la configuración en tus sistemas (repositorios, bases de datos, consolas web, APIs de gestión) y pregúntate, para cada uno, si un cambio ahí deja rastro en el mismo sitio donde miras las gráficas cuando algo va mal. La respuesta suele ser sorprendente.
Fuentes:
- Cloudflare outage on November 18, 2025 — postmortem oficial de Cloudflare.
- Google Cloud Service Health: incidente del 12 de junio de 2025 — informe de Google sobre Service Control.
- Code Orange: Fail Small is complete — Snapstone, fail stale y el código de ingeniería.
- Cloudflare outage on February 20, 2026 — el parámetro
pending_deletevacío.